Si quieres aprender inteligencia artificial, Python es el lenguaje por el que empezar, y no necesitas dominarlo entero: necesitas una parte concreta y aprenderla en el orden correcto. El camino que funciona es este: lo básico (variables, condiciones y bucles) → funciones y estructuras de datos (listas y diccionarios) → NumPy → pandas → scikit-learn → PyTorch.
En este artículo verás qué aprender en cada paso, por qué va en ese orden, pequeños ejemplos de código que puedes ejecutar hoy mismo y cómo practicar sin instalar nada (o cómo instalarlo bien si prefieres trabajar en tu ordenador).
Por qué Python y no otro lenguaje
Python es, con diferencia, el lenguaje más usado en IA. No es el más rápido del mundo, pero no le hace falta: las operaciones pesadas las ejecutan bibliotecas escritas en C, C++ o CUDA, y Python actúa como el «volante» con el que las diriges. Así consigues un código fácil de leer y, a la vez, cálculos rápidos.
Además, todo el ecosistema habla el mismo idioma: pandas guarda sus columnas como arrays de NumPy, scikit-learn recibe y devuelve arrays de NumPy, y los tensores de PyTorch copian el diseño de NumPy (forma, tipo de dato, operaciones vectorizadas). Cada paso de la ruta se apoya en el anterior. Por eso el orden importa.
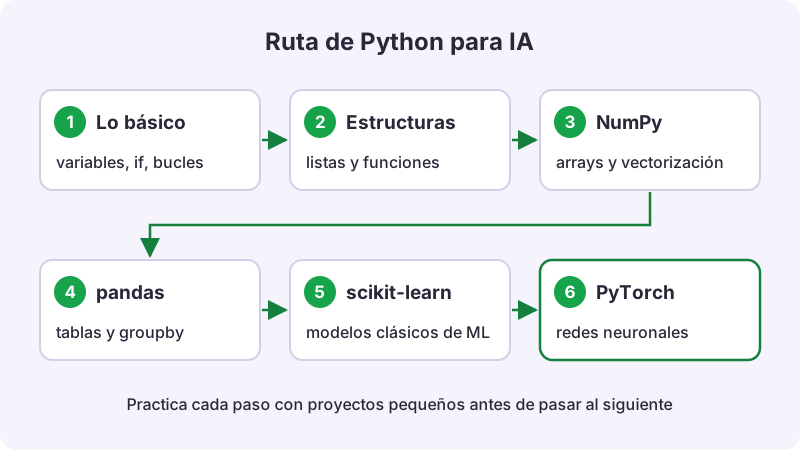
| Paso | Qué aprender | Para qué te sirve en IA |
|---|---|---|
| 1. Lo básico | variables, tipos, if, bucles for | leer y escribir cualquier programa |
| 2. Estructuras | funciones, listas, diccionarios, comprensiones | organizar datos y reutilizar código |
| 3. NumPy | arrays, vectorización, broadcasting | cálculo numérico rápido; la base de todo lo demás |
| 4. pandas | DataFrames, filtrar, agrupar, unir | explorar y limpiar datos reales |
| 5. scikit-learn | fit, predict, evaluación | machine learning clásico |
| 6. PyTorch | tensores, redes neuronales, entrenamiento | deep learning y modelos de lenguaje |
Paso 1: lo básico, sin prisas
Aquí aprendes a guardar valores en variables, a distinguir números de texto, a tomar decisiones con if y a repetir tareas con for. Parece poco, pero es la base de todo lo que escribirás cada día.
notas = [7.5, 9.0, 6.0, 8.5]

total = 0
for nota in notas:
    total = total + nota

media = total / len(notas)
print(f"Media: {media:.2f}")    # Media: 7.75

if media >= 7:
    print("Buen trimestre")
No hace falta memorizar la sintaxis. Lo importante es entender qué hace cada línea y ser capaz de predecir el resultado antes de ejecutarlo. Ese hábito, predecir y comprobar, es el que más acelera el aprendizaje.
Paso 2: funciones y estructuras de datos
Un dataset es una colección de ejemplos; un vocabulario, una colección de pares palabra → número. Por eso las listas y los diccionarios son las estructuras que más usarás. La pregunta que te guía siempre es: ¿accedo por posición o por nombre? Por posición (el ejemplo 17, los 10 primeros), lista. Por nombre (el precio del café, cuántas veces aparece «gato»), diccionario.
Este patrón, contar con un diccionario, aparece en cualquier proyecto de texto:
texto = "el gato y el perro y el pez"

conteo = {}
for palabra in texto.split():
    conteo[palabra] = conteo.get(palabra, 0) + 1

print(conteo)
# {'el': 3, 'gato': 1, 'y': 2, 'perro': 1, 'pez': 1}
Y las funciones te permiten empaquetar un cálculo para reutilizarlo. Por ejemplo, reescalar valores entre 0 y 1, algo que harás a menudo antes de entrenar un modelo:
def normalizar(valores):
    minimo, maximo = min(valores), max(valores)
    return [(v - minimo) / (maximo - minimo) for v in valores]

print(normalizar([10, 20, 30]))   # [0.0, 0.5, 1.0]
La última línea de la función usa una comprensión de lista: una forma compacta de construir una lista nueva a partir de otra. Cuando las leas con naturalidad, estarás listo para NumPy.
Un consejo: no te quedes meses en este paso aprendiendo clases, decoradores o programación asíncrona. Son útiles y llegarán, pero para empezar con datos basta con sentirte cómodo con funciones, listas y diccionarios.
Paso 3: NumPy, pensar en arrays
NumPy introduce el array: un bloque de números del mismo tipo guardados juntos en memoria. Eso permite vectorizar, es decir, expresar un cálculo sobre el array entero en vez de recorrerlo elemento a elemento con un bucle de Python. El bucle lo hace C por dentro, y la diferencia de velocidad es enorme.
Compara las dos formas de calcular la suma de los cuadrados:
import numpy as np

x = np.array([1.0, 2.0, 3.0, 4.0])

# Con un bucle de Python
total = 0.0
for v in x:
    total += v * v
print(total)          # 30.0

# Vectorizado con NumPy
print(np.dot(x, x))   # 30.0
print(x * 2)          # [2. 4. 6. 8.]
Con cuatro números no notarás nada. Con un millón, sí. Puedes medirlo tú mismo:
import time
import numpy as np

x = np.random.default_rng(0).random(1_000_000)

inicio = time.perf_counter()
total = 0.0
for v in x:
    total += v * v
t_bucle = time.perf_counter() - inicio

inicio = time.perf_counter()
total_np = np.dot(x, x)
t_numpy = time.perf_counter() - inicio

print(f"bucle: {t_bucle:.4f} s   numpy: {t_numpy:.4f} s")
En un ordenador normal, la versión de NumPy suele ser cientos de veces más rápida. Cuando el cálculo no es una suma sino comparar miles de vectores entre sí, esa diferencia separa esperar un segundo de esperar una tarde.
Lo siguiente que conviene entender es el broadcasting: operar arrays de formas distintas sin bucles. Por ejemplo, restar la media de cada columna a una tabla:
X = np.array([[1.0, 10.0],
              [3.0, 30.0]])

centrado = X - X.mean(axis=0)   # la media por columna es [2., 20.]
print(centrado)                 # filas: [-1., -10.] y [1., 10.]
Si entiendes bien NumPy, tendrás medio camino hecho para PyTorch.
Paso 4: pandas, datos con nombre
pandas es «NumPy con nombres»: un DataFrame es una tabla donde cada columna tiene nombre y su propio tipo de dato. Es la herramienta con la que se explora, limpia y prepara casi cualquier dataset antes de que un modelo vea un solo número.
La operación estrella es agrupar y resumir. Por ejemplo, ¿qué categoría factura más?
import pandas as pd

pedidos = pd.DataFrame({
    "categoria": ["libros", "juegos", "libros", "música", "juegos"],
    "precio":    [12.0, 30.0, 8.0, 15.0, 20.0],
    "unidades":  [2, 1, 3, 1, 2],
})

pedidos["ingreso"] = pedidos["precio"] * pedidos["unidades"]

resumen = (pedidos.groupby("categoria")["ingreso"]
                  .sum()
                  .sort_values(ascending=False))
print(resumen)
# juegos 70.0, libros 48.0, música 15.0
Fíjate en que no hay ni un bucle: la columna ingreso se calcula de golpe, igual que en NumPy. Pensar en columnas y no en filas es el cambio de chip más importante de este paso. Antes de hacer preguntas a una tabla nueva, acostúmbrate a mirarla con df.head(), df.shape, df.dtypes y df.describe().
Paso 5: scikit-learn, tu primer modelo
Con NumPy y pandas ya puedes preparar datos. scikit-learn te da los modelos de machine learning clásico con una interfaz muy uniforme: creas el modelo, lo entrenas con fit y predices con predict.
from sklearn.linear_model import LinearRegression

X = [[50], [70], [90], [110]]    # metros cuadrados
y = [150, 210, 270, 330]         # precio en miles de euros

modelo = LinearRegression().fit(X, y)
print(modelo.predict([[80]]))    # unos 240
Lo difícil de este paso no es el código, que es corto, sino entender qué está pasando: qué significa entrenar, por qué hay que separar datos de entrenamiento y de prueba, y cómo saber si un modelo funciona de verdad. Lo explicamos con calma en Machine learning explicado sin matemáticas.
Paso 6: PyTorch, la puerta al deep learning
PyTorch es la biblioteca más extendida para construir y entrenar redes neuronales, incluidos los modelos de lenguaje. Sus tensores se parecen muchísimo a los arrays de NumPy, pero además pueden ejecutarse en GPU y calcular gradientes automáticamente, que es lo que permite entrenar.
Llegar a PyTorch sin soltura en NumPy es el error más común. Si el paso 3 está bien asentado, este será mucho más llevadero. Aquí también empezarás a necesitar algo de matemáticas; te contamos cuáles en Matemáticas necesarias para IA (y las que no).
Cómo practicar: sin instalar nada o en tu ordenador
Sin instalar nada. Para empezar es la mejor opción, porque evitas pelearte con la configuración el primer día. Tienes entornos de Python en el navegador y cuadernos en la nube como Google Colab, que además ofrece GPU gratuita con límites de uso, útil cuando llegues a PyTorch.
En tu ordenador. Cuando quieras trabajar en local, instala Python desde la web oficial (python.org) y crea un entorno virtual para cada proyecto. Un entorno virtual es una carpeta con su propio Python y sus propias bibliotecas, para que las versiones de un proyecto no rompan las de otro:
python -m venv .venv

# Windows
.venv\Scripts\activate

# macOS / Linux
source .venv/bin/activate

pip install numpy pandas scikit-learn
Instala PyTorch más adelante, siguiendo las instrucciones de su web oficial, porque el comando exacto depende de tu sistema y de si tienes GPU.
Idea clave: el entorno da igual al principio. Lo que marca la diferencia es escribir código a diario, aunque sean 20 minutos, y resolver ejercicios en los que tengas que pensar.
Errores típicos al aprender Python para IA
- Saltar directamente a PyTorch o a los LLMs sin bases. Funciona copiando tutoriales, pero te bloqueas en cuanto algo falla.
- Estudiar sin escribir código. Ver vídeos da sensación de avance; lo que se queda es lo que practicas.
- Querer aprenderlo todo de Python antes de tocar datos. Con el paso 2 bien hecho, ya puedes empezar con NumPy.
- Escribir bucles donde NumPy o pandas lo hacen por ti. Si recorres un DataFrame fila a fila, casi siempre hay una forma vectorizada.
- No leer los mensajes de error. El error suele decirte la línea y el motivo; aprende a leerlo antes de buscarlo.
Para recursos gratuitos, el tutorial oficial de Python (disponible en español en docs.python.org) y las guías de usuario de NumPy, pandas y scikit-learn son excelentes y están siempre actualizados.
Si quieres un camino guiado
Si prefieres no montar tú la ruta, en Marsof Academy el primer curso, Fundamentos: programación y datos, sigue exactamente este orden: Python de ingeniería y después datos para IA con NumPy, pandas y SQL. Las lecciones son cortas, el código se ejecuta en el navegador sin instalar nada y avanzas demostrando que dominas cada paso. Luego continúan machine learning con scikit-learn y deep learning con PyTorch. Puedes ver el temario completo y los precios.
Y si todavía estás decidiendo cómo encaja Python en el conjunto, lee cómo aprender inteligencia artificial desde cero o la ruta de aprendizaje de IA en 12 meses.
Preguntas frecuentes
¿Necesito saber programar antes de aprender Python para IA?
No. Python es un buen primer lenguaje, y la ruta empieza desde variables y bucles. Solo necesitas constancia y practicar escribiendo código, no solo leyéndolo.
¿Cuánto Python necesito antes de pasar a NumPy?
Te basta con manejar con soltura variables, condiciones, bucles, funciones, listas y diccionarios. Las clases y otros temas avanzados puedes aprenderlos en paralelo, más adelante.
¿Tengo que instalar Python en mi ordenador?
Para empezar, no: puedes practicar en el navegador o en Google Colab. Cuando hagas proyectos más grandes, conviene instalarlo y usar un entorno virtual por proyecto.
¿Qué aprendo primero, scikit-learn o PyTorch?
scikit-learn. Te enseña los conceptos básicos del machine learning (entrenar, evaluar, sobreajuste) con muy poco código, y esos conceptos son los mismos que usarás después con PyTorch.