El machine learning (aprendizaje automático) es una forma de programar en la que, en lugar de escribir tú las reglas, le das al ordenador muchos ejemplos y él descubre las reglas por su cuenta. Si quieres un programa que distinga correos de spam, no enumeras a mano cada truco de los spammers: le enseñas miles de correos ya marcados como «spam» o «no spam» y dejas que aprenda qué los diferencia.
Esa es la idea entera. Todo lo demás (tipos de aprendizaje, entrenamiento, test, overfitting) son formas de hacerlo bien y de comprobar que ha funcionado. En este artículo lo vas a entender con analogías del día a día, sin una sola fórmula, y al final verás un ejemplo real y corto en Python.
Programación clásica frente a machine learning
En la programación clásica, una persona piensa las reglas y las escribe: «si el correo contiene ganador y premio, es spam». El programa aplica esas reglas a los datos y produce respuestas.
El problema es que muchas tareas tienen demasiadas reglas, o reglas que nadie sabe formular. ¿Qué regla exacta usas tú para reconocer la cara de un amigo, o para saber si una reseña es positiva aunque diga «no está nada mal»? Las sigues sin poder explicarlas.
El machine learning le da la vuelta al proceso: tú aportas datos y respuestas (correos y su etiqueta), y el entrenamiento produce un modelo, que es el conjunto de reglas aprendidas. Después usas ese modelo con datos nuevos que nunca ha visto.
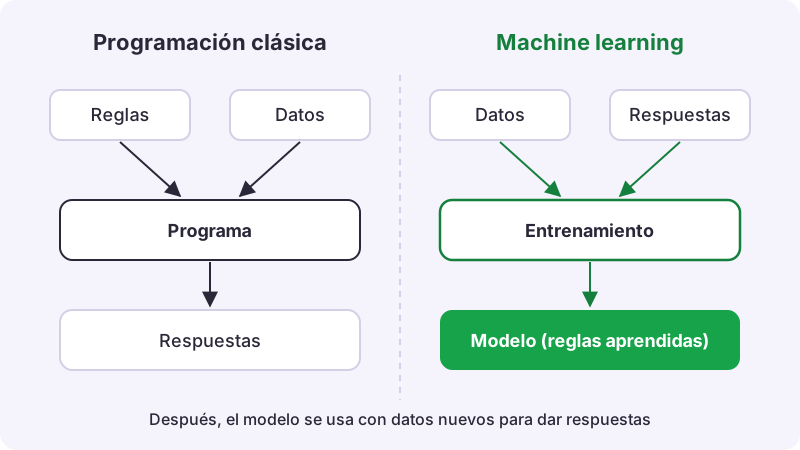
Una analogía útil es pensar en un tasador de pisos. La versión clásica es una hoja de cálculo con reglas escritas a mano («tanto más por metro, tanto menos si no tiene ascensor») que alguien hizo hace años y nadie se atreve a tocar. La versión con machine learning mira miles de ventas reales y aprende por sí sola cuánto pesa cada característica.
Cómo aprende: ejemplos, características y etiquetas
Piensa en cómo aprende un niño a distinguir perros de gatos. Nadie le da una definición; ve muchos animales, alguien le dice «eso es un perro», «eso es un gato», y poco a poco se fija en lo que importa: el tamaño, las orejas, cómo se mueven.
Un modelo de machine learning funciona de forma parecida, con tres ingredientes:
- Ejemplos: cada caso concreto que le enseñas (un correo, un piso, una flor).
- Características (en inglés, features): los datos que describen cada ejemplo. Para un piso, los metros, las habitaciones o el barrio.
- Etiqueta: la respuesta correcta que quieres que aprenda a predecir. El precio del piso, o si el correo es spam.
Entrenar consiste en ir ajustando el modelo para que sus predicciones se parezcan cada vez más a las etiquetas reales. Al principio acierta por casualidad; con cada ronda corrige un poco sus errores. Cómo se hacen exactamente esos ajustes es donde entran las matemáticas, pero la idea no las necesita: probar, medir el error, corregir, repetir.
Los tipos de aprendizaje
Aprendizaje supervisado
Es el caso más común y el que hemos descrito: cada ejemplo viene con su respuesta correcta, como un alumno que estudia con un solucionario. Hay dos grandes familias:
- Clasificación: la respuesta es una categoría. ¿Spam o no? ¿Qué especie de flor es? ¿Se dará de baja este cliente?
- Regresión: la respuesta es un número. ¿Cuánto vale este piso? ¿Cuántas unidades venderemos el mes que viene?
Aprendizaje no supervisado
Aquí no hay etiquetas. Imagina que te dan un millón de fichas de clientes y la pregunta «¿qué tipos de clientes tenemos?». Nadie sabe la respuesta de antemano. El aprendizaje no supervisado busca estructura por sí solo, por ejemplo agrupando los ejemplos que se parecen entre sí (lo que se llama clustering). Es como ordenar la ropa de un armario en montones sin que nadie te diga qué montones hacer.
Aprendizaje por refuerzo
Existe una tercera familia: un agente aprende a base de probar acciones y recibir recompensas o castigos, como quien aprende a jugar a un videojuego. Es fascinante, pero para empezar basta con dominar las dos primeras.
Entrenamiento y test: no corrijas el examen con el solucionario
Aquí está el concepto más importante de todo el machine learning, y es muy intuitivo.
Un modelo no sirve por lo bien que describe los datos con los que aprendió, sino por lo bien que acierta con datos nuevos. Evaluarlo con los mismos ejemplos del entrenamiento es como poner un examen con las mismas preguntas que el alumno ya se sabe de memoria: sacará un diez y no sabrás si ha entendido algo.
Por eso, antes de nada, los datos se separan:
| Conjunto | Para qué se usa | Analogía |
|---|---|---|
| Entrenamiento | el modelo aprende de estos ejemplos | los ejercicios del curso |
| Validación | elegir entre modelos y ajustar opciones | los exámenes de práctica |
| Test | medir el resultado final, una sola vez | el examen final, con preguntas nuevas |
La separación se hace al azar, para que cada conjunto sea representativo. Y el test se guarda bajo llave hasta el final: si lo miras muchas veces para tomar decisiones, deja de ser un examen sorpresa y el resultado que obtengas será demasiado optimista.
Overfitting: el alumno que se aprendió las respuestas
Seguro que conociste en clase a alguien que se aprendía de memoria los exámenes de otros años. Sacaba un diez si el profesor repetía preguntas y se hundía en cuanto cambiaba una coma. Eso es exactamente el overfitting (sobreajuste): el modelo memoriza los ejemplos de entrenamiento, incluidos sus errores y casualidades, en lugar de aprender la regla general.
El error contrario es el underfitting: un modelo demasiado simple que no capta ni lo básico, como quien intenta resumir un libro entero en una sola frase. Falla con los datos de entrenamiento y con los nuevos.
Cómo distinguirlos:
- Va mal en entrenamiento y en datos nuevos: el modelo se queda corto (underfitting).
- Va genial en entrenamiento pero mal en datos nuevos: ha memorizado (overfitting).
- Va bien en ambos y con resultados parecidos: buen ajuste.
Las soluciones típicas al overfitting son conseguir más datos, usar un modelo más sencillo o frenar el entrenamiento a tiempo. La intuición de fondo es siempre la misma: queremos que el modelo aprenda la señal, no el ruido.
Cómo saber si un modelo funciona de verdad
La medida más intuitiva es el acierto (accuracy): de cada cien predicciones, cuántas son correctas. Pero puede engañar mucho.
Imagina un modelo que detecta fraude en pagos con tarjeta. Si casi todos los pagos son legítimos, un modelo que diga siempre «legítimo» tendrá un acierto altísimo… y no detectará ni un solo fraude. Por eso se usan también otras preguntas:
- Precisión: de las veces que el modelo dijo «fraude», ¿cuántas lo eran de verdad? Importa cuando las falsas alarmas salen caras.
- Recall (sensibilidad): de todos los fraudes reales, ¿cuántos encontró? Importa cuando se te escapa algo grave.
No hace falta memorizar los nombres ahora. Lo esencial es la actitud: desconfía de un número espectacular y pregúntate siempre contra qué lo estás comparando y qué errores comete el modelo.
Un ejemplo real con scikit-learn
Para verlo en acción, usaremos iris, un conjunto de datos clásico que viene incluido en scikit-learn: 150 flores de tres especies, cada una descrita por cuatro medidas (largo y ancho del sépalo y del pétalo). El modelo es k vecinos más cercanos: para clasificar una flor nueva, mira las flores de entrenamiento más parecidas y vota. Es lo mismo que haces tú cuando eliges restaurante fijándote en lo que piden quienes tienen gustos parecidos a los tuyos.
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsClassifier

iris = load_iris()
X, y = iris.data, iris.target          # medidas y especie de cada flor

# Separar: 75 % para entrenar, 25 % para el test
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.25, stratify=y, random_state=0)

modelo = KNeighborsClassifier(n_neighbors=5)
modelo.fit(X_train, y_train)            # entrenar
print("Acierto en test:", modelo.score(X_test, y_test))

flor_nueva = [[5.0, 3.4, 1.5, 0.2]]     # medidas en centímetros
especie = modelo.predict(flor_nueva)[0]
print("Especie predicha:", iris.target_names[especie])   # setosa
Fíjate en que ahí está todo lo que has leído: los datos se separan antes de entrenar, el modelo aprende solo con la parte de entrenamiento y se evalúa con flores que no ha visto. En este dataset, tan limpio, el acierto en test sale muy alto; en problemas reales, rara vez es tan fácil. Si quieres saber qué Python necesitas para escribir código así, lo tienes en Python para IA: por dónde empezar.
Lo que el machine learning no es
- No es magia ni entiende el mundo. Encuentra patrones en los datos que le das. Si los datos son malos, el modelo también.
- No es neutral por defecto. Si los datos históricos contienen sesgos (por ejemplo, decisiones injustas del pasado), el modelo puede aprenderlos y repetirlos. Por eso la ética y regulaciones como el Reglamento Europeo de IA forman parte del oficio, no son un añadido.
- No siempre es la mejor solución. Si las reglas son pocas y claras, un programa clásico es más simple, barato y fácil de explicar.
Y una pregunta frecuente: ¿qué relación tiene todo esto con ChatGPT y compañía? Los modelos de lenguaje son machine learning a gran escala: redes neuronales entrenadas con enormes cantidades de texto para predecir la siguiente palabra. Lo explicamos en qué es un LLM y cómo funciona.
Si quieres un camino guiado
Las matemáticas no desaparecen: son las que explican cómo el modelo corrige sus errores, y conviene aprenderlas para ir más allá del nivel usuario. La buena noticia es que se pueden aprender en código y paso a paso; te contamos cuáles hacen falta en Matemáticas necesarias para IA (y las que no).
Si te apetece un recorrido estructurado, el curso de Machine learning de Marsof Academy parte de un puente con las matemáticas del instituto, construye regresión, clasificación, árboles y clustering primero desde cero y después con scikit-learn, pone el foco en la evaluación honesta de modelos y dedica una unidad a la ética, los sesgos y la regulación. Puedes ver el temario y los precios. Si prefieres ir por tu cuenta, la guía de usuario de scikit-learn es gratuita y muy completa.
Preguntas frecuentes
¿Es lo mismo inteligencia artificial que machine learning?
No exactamente. La inteligencia artificial es el campo amplio de hacer que las máquinas realicen tareas que asociamos a la inteligencia; el machine learning es la parte que lo consigue aprendiendo de datos, y hoy es la más importante.
¿Necesito saber matemáticas para empezar con machine learning?
Para entender las ideas y usar scikit-learn, no. Para entender por qué funcionan los modelos y resolver problemas cuando fallan, sí conviene aprender algo de álgebra lineal, probabilidad y cálculo, sin necesidad de ser matemático.
¿Cuántos datos hacen falta para entrenar un modelo?
Depende del problema: un modelo sencillo puede funcionar con cientos de ejemplos, mientras que las redes neuronales grandes necesitan muchísimos más. Más importante que la cantidad es que los datos sean representativos y estén bien etiquetados.
¿Qué diferencia hay entre machine learning y deep learning?
El deep learning es un tipo de machine learning que usa redes neuronales con muchas capas. Destaca con imágenes, audio y texto, mientras que con tablas de datos los modelos clásicos siguen siendo muy competitivos.