RAG (Retrieval-Augmented Generation, generación aumentada con recuperación) es una técnica para que un modelo de lenguaje responda usando tus documentos en lugar de solo su memoria. Antes de pedirle la respuesta, un buscador localiza los fragmentos relevantes (de tus manuales, políticas, tickets o contratos) y los pega en el prompt como contexto. El modelo pasa de responder de memoria a responder a libro abierto, y puede citar de dónde sale cada dato.
Sirve para construir asistentes que contestan sobre información privada o reciente, con menos invenciones y con fuentes que alguien puede comprobar. Es, probablemente, el patrón más habitual en las aplicaciones de empresa con LLMs. En este artículo verás por qué existe, cómo es el pipeline por dentro, cuándo conviene usarlo (y cuándo no) y los errores más comunes.
Por qué hace falta RAG
Imagina que una tienda conecta un chatbot a su web. Un cliente pregunta: «¿Cuántos días tengo para devolver un producto?». El modelo responde, muy seguro: «14 días». La política real dice 30. Nadie le había dado ese documento: respondió con lo que «suena razonable».
Esto pasa porque un LLM genera texto plausible a partir de lo que aprendió al entrenarse (si quieres el detalle, lo contamos en qué es un LLM y cómo funciona). De ahí salen tres problemas que RAG ataca a la vez:
- Fecha de corte y datos privados: el modelo no conoce lo que pasó después de su entrenamiento, ni tus documentos internos, que nunca vio.
- Alucinaciones: si no tiene el dato, se lo inventa con total seguridad. Con el texto correcto delante, tiene de dónde sacarlo.
- Trazabilidad: cada afirmación puede llevar una cita al fragmento del que sale, y un humano puede verificarla.
Además, actualizar un RAG es barato: si cambia la política de devoluciones, cambias el documento y lo vuelves a indexar. No hay que reentrenar nada.
Cómo funciona RAG, paso a paso
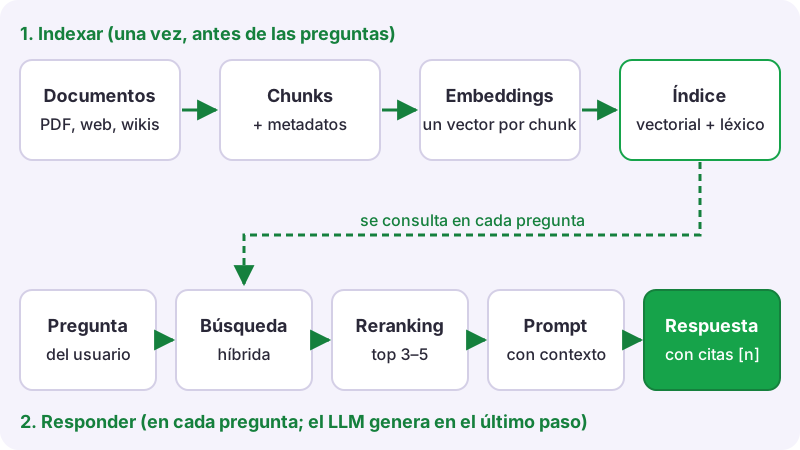
Un sistema RAG tiene dos fases. La primera se hace antes de que nadie pregunte (indexar); la segunda, cada vez que llega una pregunta (buscar y responder).
1. Ingesta y chunking
Primero se extrae el texto de los documentos (PDF, web, Word…) y se limpia: cabeceras repetidas, pies de página, tablas rotas. Parece trabajo menor, pero muchos RAG que «no funcionan» fallan justo aquí.
Después se trocea en chunks, fragmentos de unos cientos de tokens. ¿Por qué no usar el documento entero? Porque no cabría en el contexto, costaría mucho y diluiría lo importante. Los chunks suelen tener un pequeño solapamiento con el anterior, para que una idea partida por la mitad no se pierda. Y a cada chunk se le añaden metadatos: de qué documento viene, sección, fecha, quién puede verlo. Son su pasaporte, y los necesitarás para citar y para filtrar.
2. Embeddings e índice
Cada chunk se convierte en un embedding: un vector de números que representa su significado, de modo que textos parecidos quedan cerca. Todos esos vectores se guardan en un índice, normalmente una base de datos vectorial, preparado para encontrar rápido los más cercanos a una consulta.
3. Recuperación: léxica, densa o híbrida
Cuando llega una pregunta, hay que encontrar los chunks relevantes. Hay dos familias de buscadores:
- Búsqueda léxica (como BM25): busca coincidencias de palabras. Es excelente con códigos de producto, nombres propios o términos exactos, pero no sabe que «reembolso» y «devolver el dinero» significan lo mismo.
- Búsqueda densa (por embeddings): convierte la pregunta en vector y busca los chunks más cercanos por significado, normalmente con similitud coseno. Entiende sinónimos, pero puede fallar con un código exacto como «REF-4471».
Como cada una tiene puntos ciegos distintos, en la práctica se usa mucho la búsqueda híbrida: se lanzan las dos y se fusionan los rankings (una técnica habitual es Reciprocal Rank Fusion, que combina posiciones en lugar de puntuaciones, porque las puntuaciones de uno y otro buscador no son comparables).
4. Reranking
La primera búsqueda trae, por ejemplo, 50 candidatos. Un reranker (un modelo que lee la pregunta y cada chunk a la vez) los puntúa con más finura y se queda con los 3–5 mejores. Es más preciso que comparar vectores, pero más caro, por eso solo se aplica a unos pocos candidatos. Ojo: un reranker solo reordena; si el chunk bueno no estaba entre los 50, no puede rescatarlo.
5. Prompt con contexto y respuesta con fuentes
Por último, se monta el prompt: instrucciones, los chunks numerados y la pregunta. Algo como «Responde solo con la información de los fragmentos; cita cada dato con [n]; si no está, di que no lo sabes». El LLM genera la respuesta y la aplicación muestra las citas enlazadas a su documento original.
Un RAG de juguete en Python
Para ver la idea sin librerías, aquí tienes una recuperación mínima por solapamiento de palabras y el montaje del prompt. En un sistema real usarías embeddings o BM25, pero el esqueleto es el mismo:
import re

documentos = {
    "devoluciones": "Tienes 30 días naturales desde la entrega para devolver un producto.",
    "envios": "Los envíos a la península tardan entre 2 y 4 días laborables.",
    "garantia": "Todos los productos tienen 2 años de garantía por defectos de fabricación.",
}

def palabras(texto):
    return set(re.findall(r"\w+", texto.lower()))

def recuperar(pregunta, docs, k=2):
    q = palabras(pregunta)
    puntuados = []
    for doc_id, texto in docs.items():
        solape = len(q & palabras(texto)) / len(q)
        puntuados.append((solape, doc_id, texto))
    puntuados.sort(reverse=True)
    return [(doc_id, texto) for solape, doc_id, texto in puntuados[:k] if solape > 0]

pregunta = "¿Cuántos días tengo para devolver un producto?"
contexto = recuperar(pregunta, documentos)

fragmentos = "\n".join(
    f"[{i}] ({doc_id}) {texto}" for i, (doc_id, texto) in enumerate(contexto, start=1)
)
prompt = (
    "Responde solo con la información de los fragmentos y cita cada dato con [n].\n"
    "Si la respuesta no está en los fragmentos, di que no lo sabes.\n\n"
    f"{fragmentos}\n\n"
    f"Pregunta: {pregunta}"
)
print(prompt)
El fragmento de devoluciones sale primero, como esperábamos. Fíjate también en dos debilidades típicas de la búsqueda léxica: el de envíos se cuela en segunda posición solo por compartir la palabra «días», y el de garantía no coincide con la palabra «producto» porque el documento dice «productos». Esos son justo los problemas que resuelven los embeddings, la búsqueda híbrida y el reranking.
RAG, fine-tuning o contexto largo: cuándo usar cada uno
La pregunta útil es: ¿qué le falta al sistema?
| Lo que falta | Ejemplo | Técnica |
|---|---|---|
| Conocimiento que cambia o hay que citar | Catálogo, políticas, documentación interna | RAG |
| Comportamiento que se consigue con instrucciones | Tono, formato, reglas de negocio | Prompting bien hecho |
| Comportamiento que las instrucciones no logran de forma fiable | Un formato muy concreto, una tarea estrecha repetida muchísimas veces | Fine-tuning, si hay datos de calidad |
| Pocos documentos, pocas consultas | Analizar un contrato concreto | Pegarlo entero en un contexto largo |
Una escalera sensata: primero un buen prompt; si falta conocimiento, RAG; y solo si sigue habiendo una brecha de comportamiento medible, fine-tuning. No son excluyentes: un sistema maduro puede combinar las tres.
¿Por qué no usar fine-tuning para que el modelo «se aprenda» tus documentos? Porque memoriza hechos de forma poco fiable (mezcla productos parecidos), no puede citar su fuente y se queda viejo en cuanto cambian los datos.
¿Y el contexto largo? Si tus documentos caben en la ventana de contexto y se consultan poco, meterlos enteros es simple y a menudo suficiente. Pero con miles de documentos no caben, cada consulta cuesta más y tarda más, y el modelo puede pasar por alto detalles en textos muy largos. RAG envía solo lo relevante.
Cómo evaluar un RAG
«Parece que funciona» no es una evaluación. Lo básico es crear un conjunto de evaluación: entre 50 y 200 preguntas realistas (mejor si salen del uso real), con los chunks que las responden y, si puedes, una respuesta de referencia. Es trabajo manual y aburrido, y es de lo más rentable del proyecto.
Luego mides por separado las dos mitades:
- Recuperación: ¿aparece el chunk correcto entre los primeros k? (recall@k) ¿Y en qué posición? (MRR, que premia tenerlo arriba). Si la recuperación falla, ningún modelo podrá arreglarlo.
- Generación: ¿cada frase de la respuesta está respaldada por los fragmentos citados? (fidelidad). ¿Responde de verdad a la pregunta? ¿Dice «no lo sé» cuando el dato no está?
Cuando algo falla, pregunta en qué etapa se perdió la respuesta: ¿el dato no estaba en los documentos, el chunking lo partió mal, la búsqueda no lo encontró, el reranker lo bajó o el modelo lo ignoró? Clasificar los fallos así te dice qué pieza mejorar primero.
Errores comunes al montar un RAG
- Descuidar la ingesta: PDFs mal extraídos o tablas destrozadas producen chunks inútiles.
- Chunks mal dimensionados: demasiado pequeños pierden contexto; demasiado grandes diluyen lo relevante y gastan tokens. Elige el tamaño midiendo, no a ojo.
- Usar solo búsqueda densa cuando los usuarios buscan códigos, referencias o nombres exactos.
- No filtrar por permisos: si cada usuario puede ver documentos distintos, el filtro va en la búsqueda, no en el prompt.
- Olvidar la frescura: documentos que cambian o se borran y siguen en el índice con su versión antigua.
- No pedir citas ni comprobarlas: sin citas verificables pierdes la mitad del valor de RAG.
- No evaluar: cambiar piezas «a ver si mejora» sin un conjunto de preguntas fijo.
Si quieres un camino guiado
Puedes empezar por tu cuenta: la documentación de las bases de datos vectoriales y de las librerías de embeddings más conocidas incluye tutoriales gratuitos, y un RAG pequeño con NumPy es un gran primer proyecto. Si te faltan bases, empieza por Python para IA o por la guía de cómo aprender inteligencia artificial desde cero.
Si prefieres un itinerario ordenado, en Marsof Academy la unidad de RAG construye un pipeline completo desde cero (chunking, búsqueda léxica y densa, híbrida con reranking, prompt con citas y evaluación), y la de aplicaciones con LLMs en producción trata frescura, permisos y cuándo elegir RAG o fine-tuning. El curso de aplicaciones con LLMs se puede empezar justo después de los fundamentos de Python. Tienes el detalle en el temario.
Preguntas frecuentes
¿RAG elimina por completo las alucinaciones?
No. Las reduce mucho cuando la recuperación encuentra el fragmento correcto, pero el modelo aún puede interpretar mal el contexto o completar huecos. Por eso se piden citas, se permite responder «no lo sé» y se evalúa la fidelidad.
¿Necesito una base de datos vectorial para hacer RAG?
Para empezar, no: con pocos documentos basta calcular similitudes con NumPy o usar búsqueda léxica. La base de datos vectorial compensa cuando tienes muchos chunks y necesitas buscar rápido.
¿Qué diferencia hay entre RAG y fine-tuning?
RAG le da al modelo información en el momento de responder; el fine-tuning cambia el propio modelo con más entrenamiento. Para conocimiento que cambia o hay que citar, RAG; para comportamientos que el prompt no consigue, fine-tuning.
¿Hace falta saber programar para montar un RAG?
Para montar uno que funcione bien y entender por qué falla, sí: al menos Python básico y algo de manejo de datos. Existen herramientas sin código, pero ajustar, evaluar y depurar un RAG es trabajo de ingeniería.