Un LLM (Large Language Model, modelo grande de lenguaje) es un programa entrenado con enormes cantidades de texto para hacer una sola cosa: predecir cuál es el siguiente trozo de texto a partir de lo que ya tiene delante. Los asistentes de chat que usas a diario están construidos sobre un LLM. Cuando te responde, no busca la respuesta en una base de datos: la va escribiendo pieza a pieza, eligiendo en cada paso una continuación probable.
Esa idea tan simple, aplicada a escala con una arquitectura llamada Transformer, produce textos que parecen escritos por una persona. Aquí verás, sin fórmulas, las piezas que lo hacen posible y por qué un LLM a veces se inventa cosas con total seguridad.
Tokens: el modelo no lee letras ni palabras
Lo primero que ocurre con tu texto es que se trocea en tokens. Un token es un fragmento: a veces una palabra entera («casa»), a veces un trozo («-ción», « de»), a veces un signo de puntuación. Cada token tiene un número de identificación dentro de un vocabulario fijo, que suele tener decenas de miles de entradas.
¿Quién decide los trozos? Un algoritmo que se ejecuta antes de entrenar el modelo. El más extendido es BPE (Byte Pair Encoding), un algoritmo de compresión de 1994: empieza con caracteres sueltos y va fusionando el par de fragmentos que más veces aparece juntos, una y otra vez, hasta llegar al tamaño de vocabulario deseado. Así, lo frecuente acaba siendo un solo token y lo raro se descompone en trozos conocidos.
Esto explica dos cosas que quizá hayas notado:
- Por qué a veces un chatbot falla al contar letras de una palabra: no ve letras, ve trozos.
- Por qué el mismo texto puede costar más tokens en español que en inglés: si el tokenizador se entrenó con más inglés, las palabras en español se parten en más trozos. Y como las APIs cobran por token, eso se nota en la factura.
La idea central: predecir el siguiente token
Un LLM recibe una secuencia de tokens y devuelve, para cada token de su vocabulario, una probabilidad de que sea el siguiente. Si le das «El gato se subió al», el modelo podría repartir la probabilidad más o menos así: «tejado» mucha, «árbol» bastante, «sofá» algo, «nube» casi nada.
Luego se elige un token de esa lista, se añade al texto y se repite el proceso con la secuencia ya ampliada. Token a token, hasta que el modelo produce un token especial de «fin» o se alcanza un máximo. Esto se llama generación autorregresiva: cada paso usa lo que el modelo escribió en los pasos anteriores.
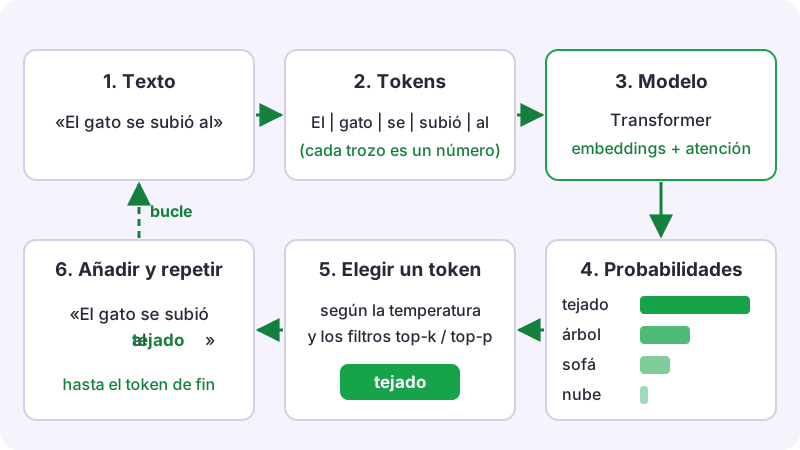
Idea clave: un LLM no «piensa la respuesta entera» y luego la escribe. Escribe un token, lo añade y vuelve a empezar. Todo lo que parece razonamiento sale de este bucle.
¿Cómo aprende a hacer buenas predicciones? Durante el entrenamiento se le enseña muchísimo texto con un ejercicio automático: tapar el siguiente token y pedirle que lo adivine. Si falla, se ajustan un poco sus parámetros (los números internos del modelo, que en los LLM actuales se cuentan por miles de millones) para que la próxima vez acierte algo más. No hace falta que nadie etiquete nada: el propio texto es la respuesta correcta.
Embeddings: convertir tokens en significado
Un número de identificación («el token 4.817») no dice nada sobre lo que significa. Por eso, lo primero que hace el modelo con cada token es cambiarlo por un embedding: una lista de cientos o miles de números, un vector, que actúa como sus coordenadas en un «mapa de significados».
La gracia es que esas coordenadas no las escribe nadie: se aprenden durante el entrenamiento. Y como palabras que aparecen en contextos parecidos acaban cerca en ese mapa, «portátil» y «ordenador» quedan próximos, y «ordenador» y «nube» quedan lejos. Para medir lo cerca que están dos vectores se suele usar la similitud coseno, que compara su dirección.
Esta idea también es la base de la búsqueda por significado que verás en qué es RAG.
El Transformer y la atención, en una imagen
Un embedding por sí solo tiene un problema: la palabra «banco» tiene el mismo vector en «me senté en el banco del parque» y en «pedí un préstamo al banco». Hace falta que cada token mire a su alrededor para entender qué significa aquí.
Eso es lo que hace el mecanismo de atención, la pieza central del Transformer, la arquitectura presentada en el artículo Attention Is All You Need (2017) y que usan prácticamente todos los LLM actuales. De forma intuitiva:
- Cada token «pregunta» qué información le interesa de los demás.
- Cada token «ofrece» una descripción de lo que contiene.
- Se comparan preguntas y ofertas: los tokens más pertinentes reciben más peso.
- Cada token se actualiza mezclando la información de los demás según esos pesos.
Así, «banco» presta mucha atención a «parque» o a «préstamo», y su representación cambia en consecuencia. En un LLM de tipo GPT hay además una regla importante: cada token solo puede mirar hacia atrás, a los tokens anteriores, nunca a los siguientes. Tiene sentido: al generar, el futuro todavía no existe.
Un Transformer apila muchos bloques iguales, cada uno con atención (en varias «cabezas» en paralelo, que se fijan en cosas distintas) y una pequeña red neuronal. Al final, una última capa convierte la representación del último token en una puntuación para cada token del vocabulario, y esas puntuaciones se transforman en probabilidades.
Si quieres ver todas estas piezas programadas una a una, la unidad de Transformers del curso de deep learning las construye desde cero.
Preentrenamiento y ajuste fino: del modelo base al asistente
Un LLM útil pasa por varias etapas de entrenamiento:
- Preentrenamiento: el modelo aprende a predecir el siguiente token sobre una cantidad enorme de texto (web filtrada, libros, código…). Es la etapa más cara con diferencia y la que le da casi todo su conocimiento del lenguaje y del mundo. El resultado es un modelo base: si le escribes «¿Cuál es la capital de Francia?», puede que en vez de contestar continúe con otra pregunta, porque en internet las preguntas suelen venir en listas.
- Ajuste fino con instrucciones (instruction tuning o SFT): se sigue entrenando con ejemplos de conversaciones del tipo «instrucción → buena respuesta». Aquí aprende el formato de asistente: contestar, seguir instrucciones, respetar el turno.
- Ajuste por preferencias (técnicas como RLHF o DPO): se le muestran pares de respuestas donde una es mejor que otra, para que tienda a producir las que las personas prefieren: más útiles, más claras, más prudentes.
Temperatura: cómo se elige cada token
Volvamos a la lista de probabilidades. Hay varias formas de elegir:
- Greedy (voraz): coger siempre el más probable. Es predecible y va bien para respuestas cortas con una respuesta correcta, pero en textos largos tiende a repetirse.
- Muestrear: tirar un «dado trucado» según las probabilidades. Da variedad.
La temperatura controla cuánto se concentra ese dado. Con temperatura baja, las diferencias se exageran y casi siempre sale el favorito: respuestas más estables. Con temperatura alta, la distribución se aplana y los tokens menos probables tienen más oportunidades: más creatividad y también más disparates. Un detalle curioso: cambiar la temperatura no cambia cuál es el token favorito, solo cuánto más probable es que los demás.
Además se suelen usar filtros como top-k (quedarse solo con los k tokens más probables) o top-p (quedarse con los más probables hasta sumar, por ejemplo, el 90 % de la probabilidad), para no muestrear nunca en la «cola» de opciones absurdas.
En la práctica: para extraer datos o clasificar, temperatura baja; para una lluvia de ideas, algo más alta.
La ventana de contexto: la memoria de trabajo
Un LLM solo «ve» un número máximo de tokens a la vez: su ventana de contexto. Ahí cabe todo: las instrucciones, tu mensaje, el historial de la conversación, los documentos que le pegues y la respuesta que va generando. Lo que queda fuera, para el modelo, no existe.
Dos consecuencias prácticas:
- El modelo no recuerda conversaciones anteriores por sí mismo. Si una aplicación parece recordarte, es porque vuelve a meter información en el contexto.
- Más contexto significa más coste y más tiempo de respuesta, y no garantiza que el modelo use bien todo lo que le das: con textos muy largos puede pasar por alto detalles importantes.
Por qué alucinan los LLM (y otros límites)
Una alucinación es una respuesta falsa dicha con total seguridad. No es un fallo raro: es una consecuencia directa de cómo funciona el modelo. Un LLM está entrenado para producir texto plausible, no para comprobar si es verdad. Si no tiene el dato, generará lo que «suena bien» en ese contexto: una cita, una fecha o una política de devoluciones que parecen reales y no lo son.
Otros límites que conviene tener presentes:
- Fecha de corte: solo sabe lo que había en sus datos de entrenamiento. Lo posterior, o tus documentos privados, no los conoce.
- Cálculo y conteo: por culpa de los tokens y del bucle de predicción, puede fallar en operaciones exactas si no usa una herramienta como una calculadora o código.
- No es determinista: con muestreo, la misma pregunta puede dar respuestas distintas.
- Sesgos: reproduce patrones de los datos con los que se entrenó.
Por eso, en aplicaciones serias casi nunca se usa un LLM «a pelo»: se le dan documentos con RAG, herramientas, instrucciones claras y, sobre todo, se mide su comportamiento con evaluaciones.
Si quieres un camino guiado
Puedes empezar a explorar gratis: la documentación de PyTorch y la de las librerías de modelos de lenguaje más conocidas tienen tutoriales introductorios, y el propio artículo del Transformer se puede leer online. Si antes necesitas bases, te pueden servir nuestras guías de Python para IA y de machine learning explicado sin matemáticas.
Si prefieres un itinerario ordenado, en Marsof Academy el curso de deep learning y Transformers recorre estas piezas en orden: tokenización y embeddings en procesamiento del lenguaje, el Transformer pieza a pieza y, como proyecto, entrenar tu propio mini-GPT con GPU gratis en la nube. Y si lo que te interesa es construir productos con LLMs ya entrenados, el curso de aplicaciones con LLMs se puede empezar justo después de los fundamentos de Python. Tienes el detalle en el temario y en precios.
Preguntas frecuentes
¿Un LLM entiende lo que dice?
Depende de qué entiendas por «entender», y es un debate abierto. Lo que sí se puede afirmar es que funciona prediciendo el siguiente token y que no comprueba por sí mismo si lo que dice es verdad.
¿Qué diferencia hay entre un LLM y un chatbot?
El LLM es el modelo que predice texto. El chatbot es una aplicación construida encima: añade la interfaz, instrucciones de sistema, historial, a veces búsqueda en documentos y herramientas.
¿Necesito saber matemáticas para entender cómo funciona un LLM?
Para la intuición, no: con este artículo ya tienes el mapa. Para programar uno desde cero sí necesitas álgebra lineal básica y algo de probabilidad, que se aprenden bien con código; lo contamos en matemáticas necesarias para IA.
¿Qué es un token, en una frase?
Es el trozo de texto mínimo con el que trabaja el modelo: una palabra, parte de una palabra o un signo, cada uno con su número dentro del vocabulario.